AI研究所 Gemini / Google
Gemini 3.8 Flashの有意義な使い方|AIが書いた文章の「添削役」に回すと効く、安くて速いモデルの活かし方
AIに文章を書かせると、下書きそのものは一瞬で出てきます。困るのはそのあとで、読点の打ち方や同じ語尾の繰り返しといった細かいほころびを人が一つずつ拾っていくと、結局そこで時間が溶けます。
この工程は、安くて速いモデルに回せます。Gemini 3.8 Flashは、上位モデルが書いた文章を受け取って直す側——つまり「添削役」に据えると噛み合うモデルです。実際に、この記事の下書きをそのまま渡して添削させてみました。
- 入力14,463字に対して、所要時間は27.8秒・指摘は23件
- 費用は約4.5セント(記事内の公式単価で計算。計算式は後述)
- 採用したのは7件。残りは文体の設計にまで踏み込んだ提案で、見送りました
Gemini 3.8 Flashが公開されたのは米国時間2026年9月2日(日本時間9月3日)。前のGemini 3.7 Flashからわずか3週間、6週間でFlash系3本目のリリースです。Googleの説明はこうなっています。
3.7と同じ速度・同じ低コストのまま、これまでで最も優れた推論とコーディングのモデル(Google公式ブログより)
Googleは、速くなったとも安くなったとも言っていません。では何が変わったのか。公式のベンチマーク資料を開くと、Claude Opus 5と同等以上の項目がいくつも並ぶ一方で、汎用的なエージェント能力やPC操作を測る項目では大きく引き離されているという、はっきりした凹凸が見えます。
しかもその資料には各社のAPI価格も並記されていて、Gemini 3.8 FlashはClaude Opus 5の約7分の1の単価です(2026年12月31日までの導入価格での比較)。添削役として噛み合うのは、この凹凸と価格差があるからです。公式ベンチマークの読み方、Claude Opus 5・GPT-5.6 Solとの使い分け、料金、同時発表されたGemini 3.8 Flash Cyberまで、一次ソースで整理していきます。
法人向けAI研修の導入社数No.1*の弊社デジライズが、生成AIの基礎知識から社内導入の6ステップ・定着のポイントまでを1冊にまとめた「はじめての生成AI社内導入ガイド」を無料で配布中です。
※出典:株式会社東京商工リサーチ「法人向けリスキリングサービスに関する調査」(2026年5月/調査期間:2026年3月26日〜4月17日/調査方法:デスクリサーチおよびヒアリング/2026年3月末時点)
Gemini 3.8 Flashとは?6週間でFlash系3本目という異例のペース
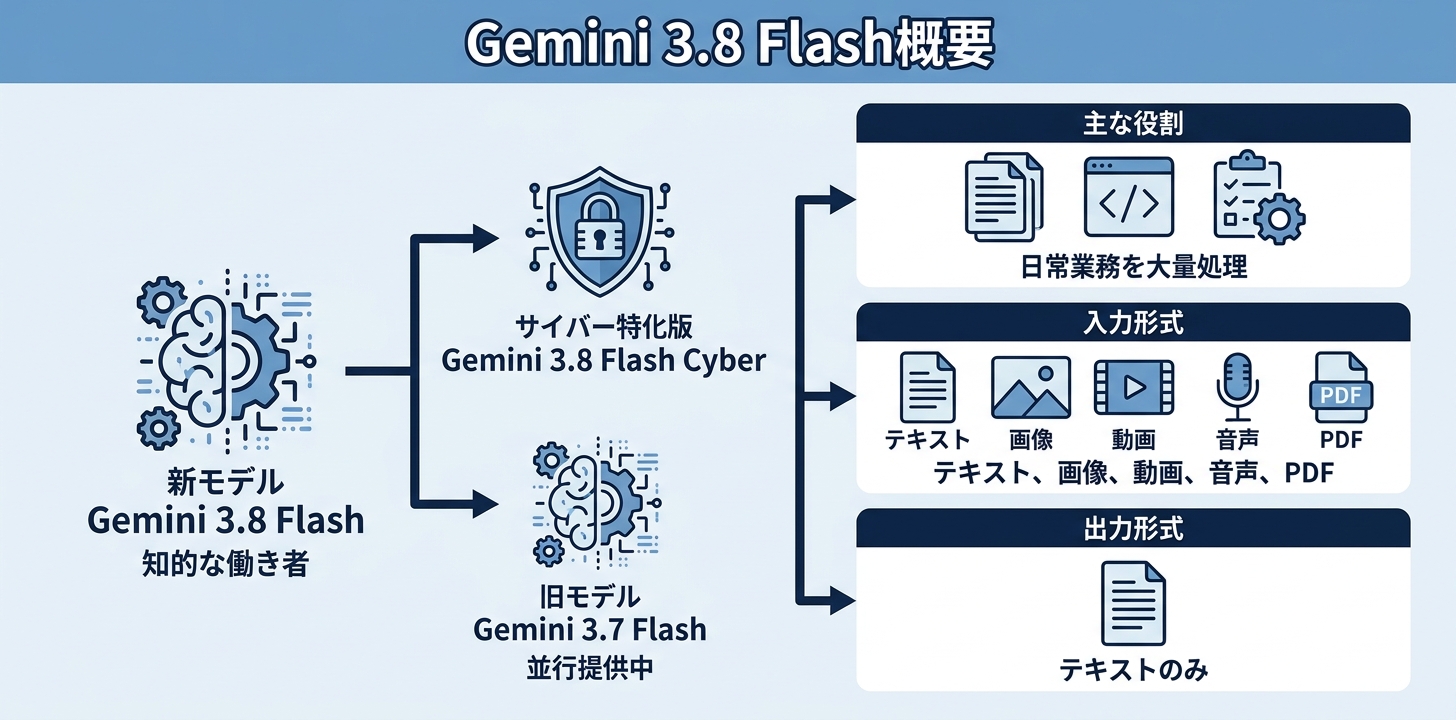
Gemini 3.8 Flashは、Googleが「最も知的な働き者(workhorse)モデル」と位置づけて公開した新モデルです。同じ日に、サイバーセキュリティに特化したGemini 3.8 Flash Cyberも発表されました(Google公式ブログより)。
「働き者モデル」という呼び方が示しているのは、最上位の推論モデルとは役割が違うということです。難問を1回だけ解くためのモデルではなく、コードを直す、書類を読む、複数の手順を踏んで作業を終わらせる——そういう仕事を毎日大量にこなす担当という位置づけになります。
まず整理しておきたいのが、3.7 Flashとの関係です。Gemini 3.8 Flashは3.7 Flashをベースに作られたモデルで(Google DeepMind「Gemini 3.8 Flash Model Card」より)、3.7 Flashが消えたわけではありません。料金ページには3.7 Flashの項目もそのまま残っています。つまり新旧が並んで提供されている状態で、今3.7 Flashで動いているものを慌てて切り替える必要があるわけではありません。
基本スペックは次のとおりです。
| 項目 | 内容 |
|---|---|
| モデルID | gemini-3.8-flash |
| 入力できるもの | テキスト・画像・動画・音声・PDF |
| 出力 | テキストのみ(音声生成・画像生成・Live APIには非対応) |
| 入力の上限 | 1,048,576トークン(約100万) |
| 出力の上限 | 65,536トークン(64K) |
| 知識のカットオフ | 2026年3月まで(領域によっては2025年1月まで) |
| 思考の深さ | low・medium(既定)・highの3段階 |
(出典: Google「Gemini 3.8 Flash」モデル仕様、Google DeepMind「Gemini 3.8 Flash Model Card」)
知識のカットオフは読み方に注意が必要です。学習データは2026年3月までとされていますが、モデルカードには「領域によっては2025年1月までの知識にとどまる」という趣旨の但し書きが併記されています。分野によって新しさが違うということなので、最新の制度・料金・仕様を扱わせるときは、Google検索との接続を有効にするか、手元の一次資料を読ませて使うのが安全です。
もうひとつ、既存の実装から乗り換えるときに引っかかりやすいのがパラメータの扱いです。Gemini 3.8 Flashへの移行ガイドでは、temperature・top_p・top_kは非推奨のパラメータとして生成設定から削除するよう案内されています。candidate_countはGemini 3以降で非対応です。
思考量の指定はthinking_budgetからthinking_levelに変わっており、minimalを指定するとエラーになります(Gemini API 移行ガイドより)。古い設定のまま呼び出すとエラーになるものが含まれるので、切り替えを検討するなら最初に見る場所はここです。
Gemini 3.8 Flashの有意義な使い方——AIが書いた文章の「添削役」に回す
なぜ「添削役」なのか
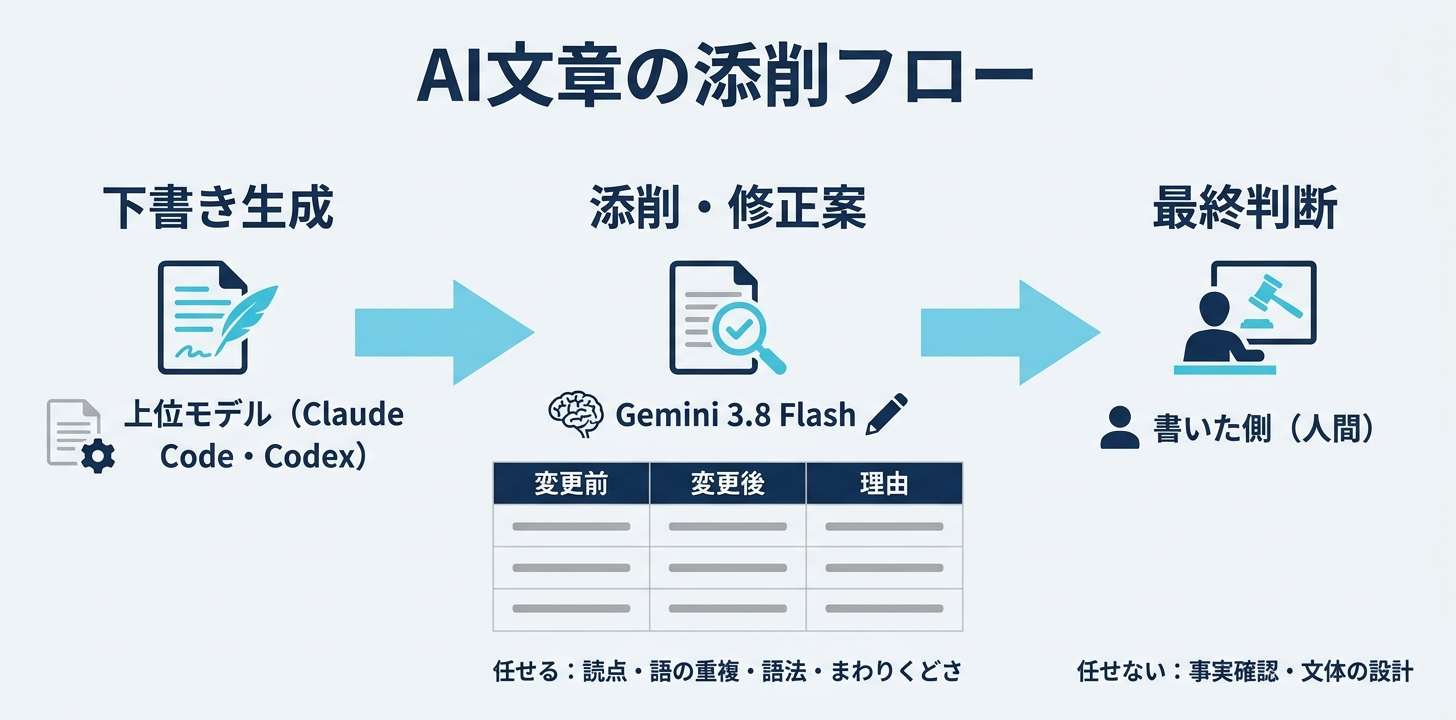
文章を書かせるモデルと、文章を整えるモデルは、同じである必要がありません。CodexやClaude Codeが生成した文章を、Gemini 3.8 Flashで添削するのは結構良いです。API費用が安価なので、CodexやClaude CodeとAPIでつないでおけば、生成した文章をそのまま自動で添削できます。
フロンティアモデルの競争ではやや目立ちにくいのですが、「安い・速い・十分高性能」なモデルは、サービスに組み込むAPIとしてかなり重宝します。Gemini 3.8 Flashは、まさに縁の下の力持ちです。
| 工程 | 任せるモデル | 単価(100万トークンあたり・入力/出力) |
|---|---|---|
| 書く(下書きの生成) | Claude Opus 5などの上位モデル | $5.00 / $25.00 |
| 整える(添削・指摘出し) | Gemini 3.8 Flash | $0.75 / $3.75 |
(出典: Google DeepMind「Gemini 3.8 Flash Model Evaluation」(PDF)。価格の内訳と2027年1月からの改定は後述の料金の章を参照)
単価の開きは約7分の1です。この差があるので、下書きを書いたモデルにもう一度全文を読ませるのではなく、整える工程だけを別のモデルに渡す——という組み方が成り立ちます。
実際に試した結果——1.4万字の下書きに23件の指摘
試したのは、Claude Codeで下書きした解説記事です。14,463字の本文をGemini APIのgemini-3.8-flashにそのまま渡し、変更点の表だけを返すよう依頼しました。生成設定は既定のまま(思考レベルは既定のmedium)です。
| 項目 | 実測値 |
|---|---|
| 入力 | 14,463字/7,726トークン |
| 所要時間 | 27.8秒 |
| 出力 | 2,395トークン(表)+思考8,008トークン |
| 指摘件数 | 23件 |
| 費用 | 約$0.045(約4.5セント) |
費用の内訳は、入力が7,726トークン×$0.75÷100万=$0.0058、出力が(2,395+8,008)トークン×$3.75÷100万=$0.0390で、合わせて約$0.045です。2027年1月1日以降の通常価格で計算すると、倍の約9セントになります。
引用の精度も見ておきました。返ってきた表の「変更前」は、23件中18件が原稿と完全に一致。残りの5件も太字記号(**)をまたぐ箇所で記号が落ちていただけで、記号を外して照合すれば23件すべて一致します。原稿に無い文を直したことにする取り違えは0件でした。
採用した指摘は7件です。そのうち4件を、返ってきた表の「変更前」「変更後」のまま並べます。
| 種別 | 変更前 | 変更後 |
|---|---|---|
| 冗長 | この差で順位を語るのは無理があります(この点は次の次のH3で詳しく触れます)。 | この差で順位を語るのは無理があります(この点は後述の評価条件の項で詳しく触れます)。 |
| 冗長 | 今3.7 Flashで動いているものを慌てて切り替える必要がある、という話ではありません。 | 今3.7 Flashで動いているものを慌てて切り替える必要があるわけではありません。 |
| 冗長 | 年内が安いという事実は、そのまま「検証を今のうちに進めておく理由」になります。 | 年内の単価が安いという事実は、そのまま「検証を今のうちに進めておく理由」になります。 |
| 硬い | 単価が7分の1でも安くは付きません。やり直しが増えれば、そのぶんトークンを使うためです。 | 単価が7分の1でも安くは上がりません。やり直しが増えれば、そのぶんトークンを消費するためです。 |
見送ったものも同じ形で4件挙げます。理由は大きく2系統で、ひとつは意味が変わらないまま硬くなる言い換え、もうひとつは依頼文で禁じたはずの敬体化です。
| 種別 | 変更前 | 変更後(採らず) | 見送った理由 |
|---|---|---|---|
| 冗長 | これだけ負けている項目を並べて出していること自体が、このモデルの立ち位置の説明になっています。 | これだけ劣後する項目を並べて開示していること自体が、このモデルの立ち位置を如実に示しています。 | 意味は同じで、語が硬くなるだけ |
| 硬い | 分野によって新しさが違うということなので、最新の制度・料金・仕様を扱わせるときは、Google検索との接続を有効にするか、 | 分野によって知識の鮮度が異なるため、最新の制度・料金・仕様を扱わせる際は、Google検索との接続を有効にするか、 | 平易な語をあえて選んでいる箇所 |
| 文体 | 0.3ポイント差で順位を語らない、条件が揃っていない項目は「傾向」として受け取る。 | 0.3ポイント差で順位を語らず、条件が揃っていない項目は「傾向」として受け取る。 | 常体で切るリズムを狙った文 |
| 文体 | 2027年1月1日から倍額になるので、試算は倍額側で組む | 2027年1月1日から倍額になるため、試算は通常価格を前提に組んでおく必要があります | 同上 |
常体や体言止めで切った文を敬体に直す提案は、23件のうち6件ありました。依頼文では「常体で切っている文をまとめて敬体に直さない」と明示していたので、指示に従わなかった分として全部見送っています。
任せること・任せないこと
指摘の中身を並べてみると、効く領域とそうでない領域がはっきり分かれます。
| 中身 | |
|---|---|
| 任せること | 読点の打ち方/同じ語の重複/語法の誤り/まわりくどい言い回し/「次の次のH3で」のような編集者目線のメタ表現の検出 |
| 任せないこと | 事実確認と数字の検証(人が別の工程で行う)/文体の設計(常体で切るリズム、平易な語の選択) |
とくに数字は、添削の工程で一緒に見てもらおうとしないほうが安全です。文章のなめらかさと、数字が一次ソースと合っているかは別の問題で、まとめて頼むと後者が甘くなります。
運用の結論はシンプルです。全文を書き直させず「変更点の表」で出させ、採るか採らないかは書いた側が1件ずつ決める。 この形にしておけば、意図した文体まで書き換えられる事故が起きません。
Claude Code・Codexとつなぐときの組み方
生成の直後に添削を挟む形にしておくと、指摘を出すところまでは自動で回せます。考え方としては次の5点です。
- APIキーとモデルIDを用意する — モデルIDは
gemini-3.8-flash。移行ガイドではtemperatureなどのサンプリング設定を削除するよう案内されているので、冒頭の「Gemini 3.8 Flashとは?」で触れたパラメータの注意点もあわせて確認してください - 依頼文を固定する — 「変えないこと」「直すこと」「出力は表だけ」の3枠で書き、毎回同じものを使う
- 「変更前」を完全な引用で出させる — 原稿と完全一致した指摘だけを置換する。一致しないものは保留にして人が見る
- 照合の前に記号を外す — 今回は5件が太字記号をまたいで記号落ちした。
**などを取り除いてから突き合わせると取りこぼしが減る - 事実確認は別の工程に残す — 添削の依頼文に混ぜず、数字とURLのチェックは独立させる
依頼文の3枠は、実際には次のような中身です。
【変えないこと】事実・数字・固有名詞・URL・引用は変えない、足さない/
見出しの構成と順序は変えない/敬体は維持し、常体で切っている文をまとめて敬体に直さない
【直すこと】硬い・まわりくどい・翻訳調/同じ語尾や同じ語の繰り返し/
一文が長すぎる/主語と述語のねじれ/読点の打ち方
【出力】全文は出力しない。①番号 ②箇所 ③変更前 ④変更後 ⑤種別 ⑥理由 の表だけを出す。
「変更前」は原稿からの完全な引用にする(1文字も変えない・省略しない)
文章を書く側のClaude Codeについては、こちらの記事で基本から解説しています。
 2026.04.20
2026.08.10
Claude Codeとは?Web版やCoworkとの使い分けから使い方・料金を徹底解説
ここまで読んで「うちの業務にもAPIで組み込めそうだ」と感じた方へ。法人向けAI研修の導入社数No.1*の弊社デジライズが、AIコンサルティング&開発のサービス資料を無料でお送りしています。既製のAIサービスでは要件が満たせず、自社に合わせたシステム構築や環境の検討が必要な場合の進め方をまとめています。
※出典:株式会社東京商工リサーチ「法人向けリスキリングサービスに関する調査」(2026年5月/調査期間:2026年3月26日〜4月17日/調査方法:デスクリサーチおよびヒアリング/2026年3月末時点)
公式ベンチマークで見る実力——Opus 5に並んだ項目、離された項目
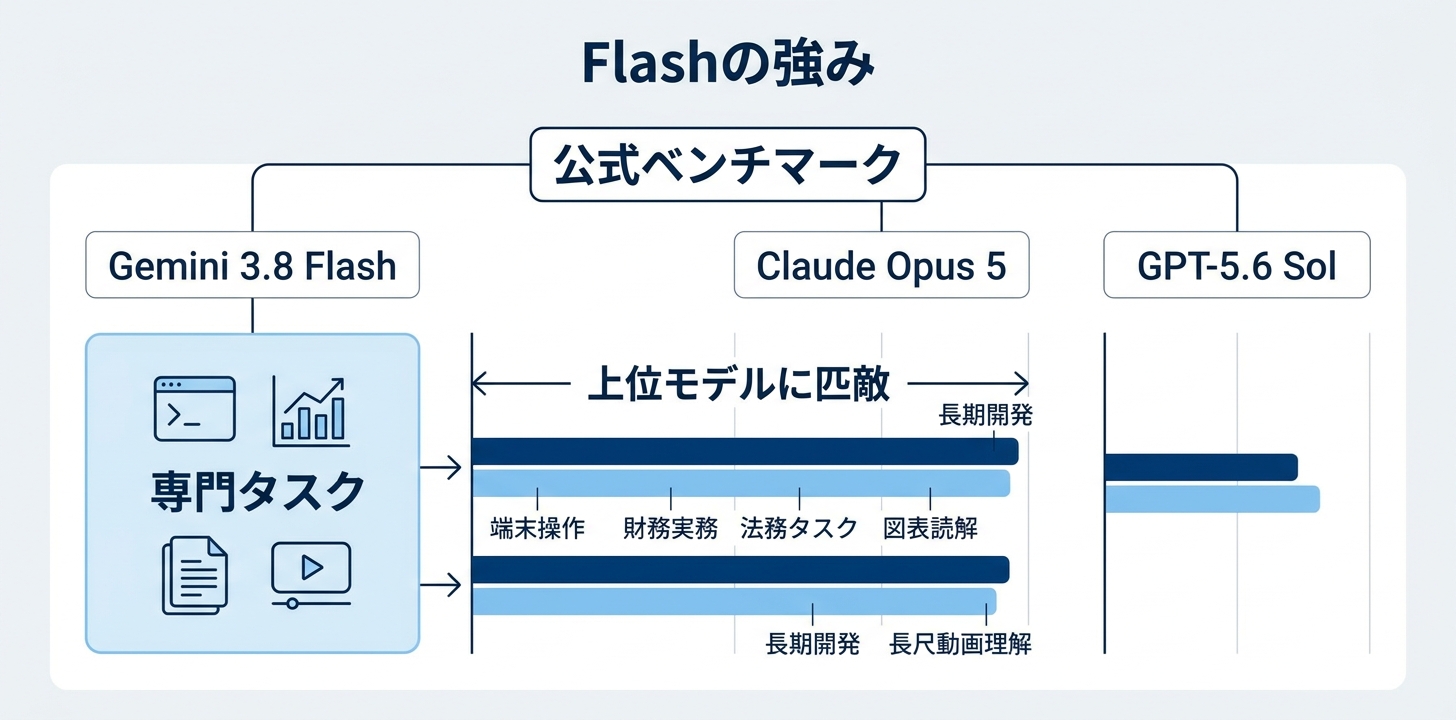
Googleは今回、比較対象をGemini 3.7 Flash・Claude Opus 5・Claude Sonnet 5・GPT-5.6 Sol・GPT-5.6 Terraの5モデルに固定した評価資料を公開しています。以下の数値はすべてこの資料(PDF・4ページ)に載っているものです。読みやすさのため、表では3.7 Flash・Claude Opus 5・GPT-5.6 Solの3列を並べています。
数字だけを眺めると「Flashなのに上位モデルに勝っている」と読めてしまうのですが、項目ごとに勝ち負けの傾向がまったく違うのが今回のポイントです。順番に見ていきます。
Opus 5に並んだ・上回った項目
| ベンチマーク | 何を測るか | 3.8 Flash | 3.7 Flash | Claude Opus 5 | GPT-5.6 Sol |
|---|---|---|---|---|---|
| Terminal-bench 2.1 | 端末上でのエージェント作業 | 89.4% | 85.8% | 89.1% | 88.8% |
| DeepSWE v1.1 | 長期のソフトウェア開発 | 73.7% | 65.3% | 74.0% | 72.7% |
| Vals Finance Agent v2 | 財務まわりの実務 | 61.4% | 59.0% | 58.6% | 53.8% |
| Harvey’s Legal Agent Benchmark | 法務タスク(全項目pass率) | 10.0% | 8.8% | 6.7% | 2.5% |
| CharXiv Reasoning | グラフ・図表の読解(ツール不使用) | 86.2% | 84.5% | 83.7% | 85.8% |
| LVBench | 長尺動画の理解 | 87.8% | 85.4% | 75.4% | 82.1% |
| HLE-Verified | 専門家級の難問推論 | 54.9% | 53.6% | 54.4% | 54.5% |
| LABBench2 | 生物学の実務研究 | 86.2% | 82.1% | 84.2% | 82.1% |
| BioMysteryBench(Difficult) | 人間でも難しい生物学の推理問題 | 56.5% | 43.5% | 49.4% | 44.7% |
(出典: Google DeepMind「Gemini 3.8 Flash Model Evaluation」(PDF)。LVBenchはエージェント設定で87.8%、静的設定で87.1%)
目を引くのは、財務と法務という「専門文書を大量にさばく」領域で、比較対象6モデルの中で最高値になっていることです。財務エージェントのVals Finance Agent v2が61.4%、法務のHarvey’s Legal Agent Benchmarkが10.0%。とくに法務側は全項目をパスした割合を見る厳しい指標で、6モデルすべてが1割前後かそれ以下という水準ですが、その中では頭ひとつ出ています。
長尺動画の理解(LVBench 87.8%)とグラフ読解(CharXiv Reasoning 86.2%)も高い値です。テキスト以外の資料を読ませる用途は、Flash系の得意分野として残っていると読めます。
一方、DeepSWE v1.1の73.7%とClaude Opus 5の74.0%は0.3ポイント差です。この差で順位を語るのは無理があります(この点は、このあとの「このベンチ表の読み方」で詳しく触れます)。BioMysteryBenchのHuman Solvable側も88.8%で、Claude Opus 5の90.1%に次ぐ2番手です。
逆に大きく離されている項目
| ベンチマーク | 何を測るか | 3.8 Flash | 3.7 Flash | Claude Opus 5 | GPT-5.6 Sol |
|---|---|---|---|---|---|
| Terminal-bench 4.0 | 汎用的なエージェント能力 | 19.1% | 11.2% | 51.8% | 37.3% |
| OSWorld-2.0 | PC画面の操作(部分スコア) | 59.0% | 50.6% | 75.4% | 62.6% |
| GDPVal-AA v2 | 幅広い知識労働(Eloスコア) | 1545 | 1482 | 1824 | 1710 |
| GDP.PDF | 専門的なPDFの読解(全項目pass率) | 35.0% | 34.0% | 37.0% | 40.0% |
(出典: Google DeepMind「Gemini 3.8 Flash Model Evaluation」(PDF)。OSWorld-2.0はbatch tool有効時の部分スコア)
差がいちばん大きいのはTerminal-bench 4.0です。3.8 Flashの19.1%に対してClaude Opus 5は51.8%。3.7 Flashの11.2%からは伸びていますが、桁が違うと言っていい開きが残っています。
同じ「ターミナルでの作業」を測るベンチマークでも、2.1では横並び、4.0では大差という結果です。差の理由までは、この資料からは読み取れません。長期のソフトウェア開発を測るDeepSWE v1.1では73.7%対74.0%とほぼ並んでいるので、「長い作業は全部苦手」とまでは言えない点にも注意が必要です。
PC操作のOSWorld-2.0(59.0%対75.4%)、幅広い知識労働を測るGDPVal-AA v2(1545対1824)も同じ方向の差です。専門PDFの読解を見るGDP.PDFでは35.0%で、最高値はGPT-5.6 Solの40.0%でした。
Googleが自社の発表資料の中で、これだけ負けている項目を並べて出していること自体が、このモデルの立ち位置の説明になっています。全部で勝つモデルではなく、得意な仕事を安く大量にこなすモデルという主張です。
このベンチ表の読み方——条件を確認してから受け取る
ここが今回いちばん伝えたい部分です。上の数字は、すべてが同じ条件で測られたものではありません。評価資料には測定方法の注記が付いていて、そこを読まずに数字だけを比べると判断を誤ります。
- 他社モデルのスコアは原則「各社の自己公表値」 — Gemini以外の数値は、基本的に各プロバイダーが公表している値を持ってきたものだと明記されています。同じ環境で横並びに測り直した結果ではありません
- HLE-VerifiedとGDP.PDFは全モデルをGoogleが自己計測 — HLE-Verified(1,811問)には、Claude Sonnet 5では相当数、Claude Opus 5でも一部の設問がコンテンツポリシーによってブロックされたという注記があります。答えられなかった分がそのままスコアに響いている可能性があり、Claude側の数値は下振れしている前提で見る必要があります
- LVBenchは入力できるフレーム数が揃っていない — GeminiとGPT-5.6が1024フレームなのに対し、Claude系はAPIの制限で300フレームです。動画から拾える情報量が最初から違うので、この項目の差をモデルの理解力の差として読むのは危険です
- OSWorld-2.0は出どころが混在 — Gemini系とClaude Sonnet 5はGoogleの自己計測、GPT-5.6 Terraは公式ブログから、Claude Opus 5はAnthropicのブログ記事からの転記です
- 第三者の公開リーダーボード由来の項目もある — GDPVal-AA v2、Vals Finance Agent v2、Harvey’s Legal Agent Benchmarkは外部の公開値からの引用です。DeepSWE v1.1も公開リーダーボードから各モデルの最高スコアを採用し、3.8 Flashのみ特定のハーネスと高い思考レベルでGoogleが自己計測しています
さらに、この資料にはGoogle自身の訂正も書かれています。DeepSWEにおけるClaude Opus 5のスコアについて、公開リーダーボードの端数処理が原因で当初74%と誤って報告していたという趣旨の注記です(いずれもGoogle DeepMind「Gemini 3.8 Flash Model Evaluation」(PDF)より)。
これは「Googleが数字を盛っている」という話ではありません。むしろ測定条件と訂正を自分から開示しているのは誠実な部類です。私が言いたいのは、ベンチマークは条件とセットで初めて意味を持つということです。0.3ポイント差で順位を語らない、条件が揃っていない項目は「傾向」として受け取る。その姿勢で見れば、この資料から読み取れることははっきりしています——Terminal-bench 2.1やDeepSWE v1.1では上位モデルに肉薄する、Terminal-bench 4.0やOSWorld-2.0ではまだ差がある。
Claude Opus 5・GPT-5.6 Solとどう使い分けるか
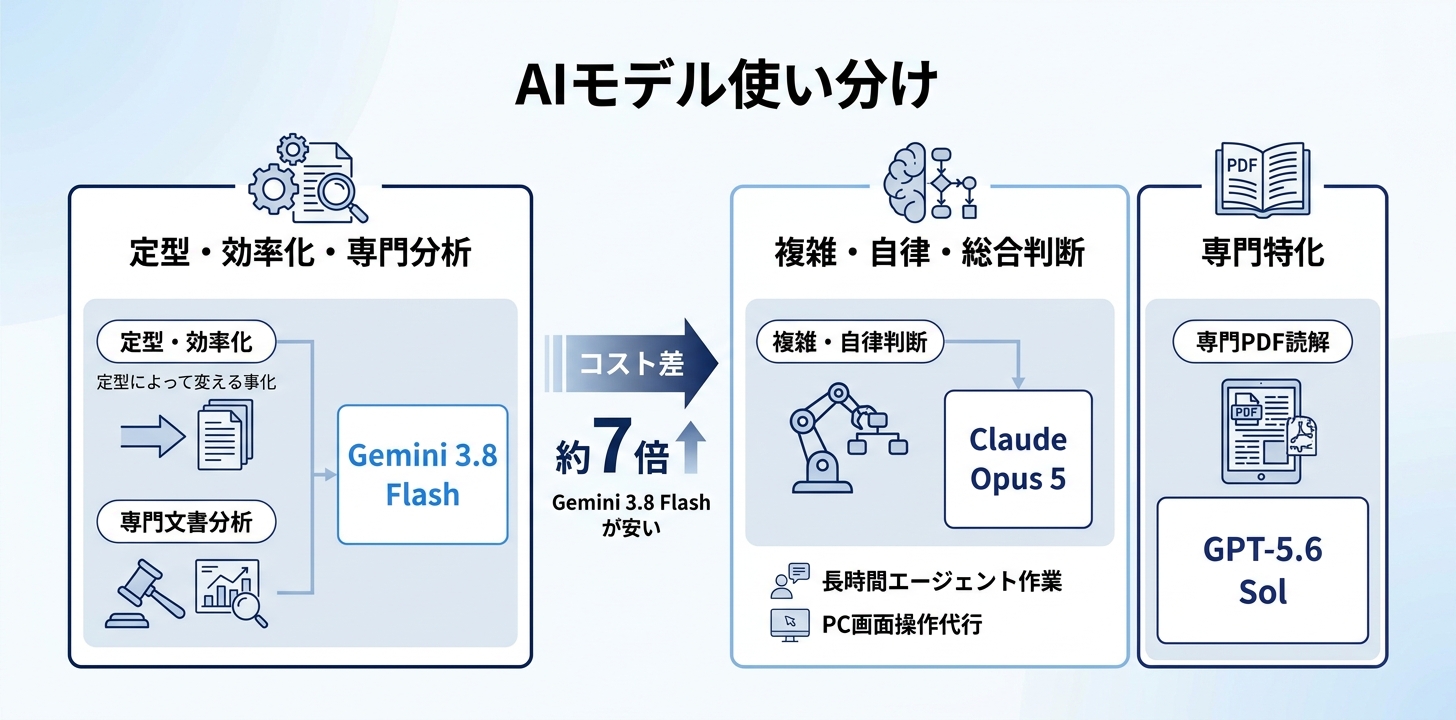
ここまで読んで「じゃあうちの業務ではどれを使えばいいのか」が知りたくなったと思います。ベンチマークの凹凸を業務の言葉に置き換えると、次のような整理になります。
| こういう仕事 | 向いているモデル | 判断のもとにした公式ベンチ |
|---|---|---|
| 手順が決まった作業を毎日大量に回す(定型のコード修正・文書の要約と分類・一次回答の下書き) | Gemini 3.8 Flash | Terminal-bench 2.1で89.4%とClaude Opus 5(89.1%)と横並び |
| 財務資料の読み取り・契約書や規程のチェックなど、専門文書を数多くさばく | Gemini 3.8 Flash | Vals Finance 61.4%・Harvey法務 10.0%で比較6モデル中の最高値 |
| グラフや長尺の動画など、テキスト以外の資料を読ませる | Gemini 3.8 Flash | CharXiv 86.2%・LVBench 87.8% |
| 汎用的なエージェント作業をまるごと任せる | Claude Opus 5 | Terminal-bench 4.0で51.8%対19.1% |
| PC画面を操作させて業務を代行させる | Claude Opus 5 | OSWorld-2.0で75.4%対59.0% |
| 職種横断の知識労働を総合的に任せる | Claude Opus 5 | GDPVal-AA v2で1824対1545 |
| 専門的なPDFの読解が仕事の中心 | GPT-5.6 Sol | GDP.PDFで40.0%と最高値 |
(数値の出典: Google DeepMind「Gemini 3.8 Flash Model Evaluation」(PDF)。測定条件は前章の注記を参照)
言い換えると、決まった作業を大量に安く回すならGemini 3.8 Flash、汎用的なエージェント作業やPC操作まで任せるならClaude Opus 5という線引きです。同じ「AIに任せる」でも、この2つは違う仕事だと考えたほうがうまくいきます。しかも両者には単価で約7倍の開きがあるので(次章の価格表を参照)、この切り分けはそのままコストの話になります。
現場で効いてくるのは、業務の側をこの線に合わせて切り分けられるかどうかです。たとえば「議事録から課題を抽出して、担当者を割り振って、関係部署に確認を取る」という一連の流れをまるごと1つのエージェントに任せると、後半の判断が多い部分で崩れます。前半の「読んで抽出して整形する」だけを安いモデルに大量に回し、判断が要る部分だけを上位モデルか人に残す。この分け方ができると、コストも精度も両立しやすくなります。
もうひとつ付け加えると、ベンチマークの順位はあなたの業務での順位ではありません。上の表は当たりをつけるためのもので、最後は自社の実データを使った小さな比較で決めるべきものです。過去の依頼を20件ほど用意して同じプロンプトを流し、出力を人が採点する——それだけでも判断材料としては十分に機能します。
料金は3.7 Flashから完全据え置き
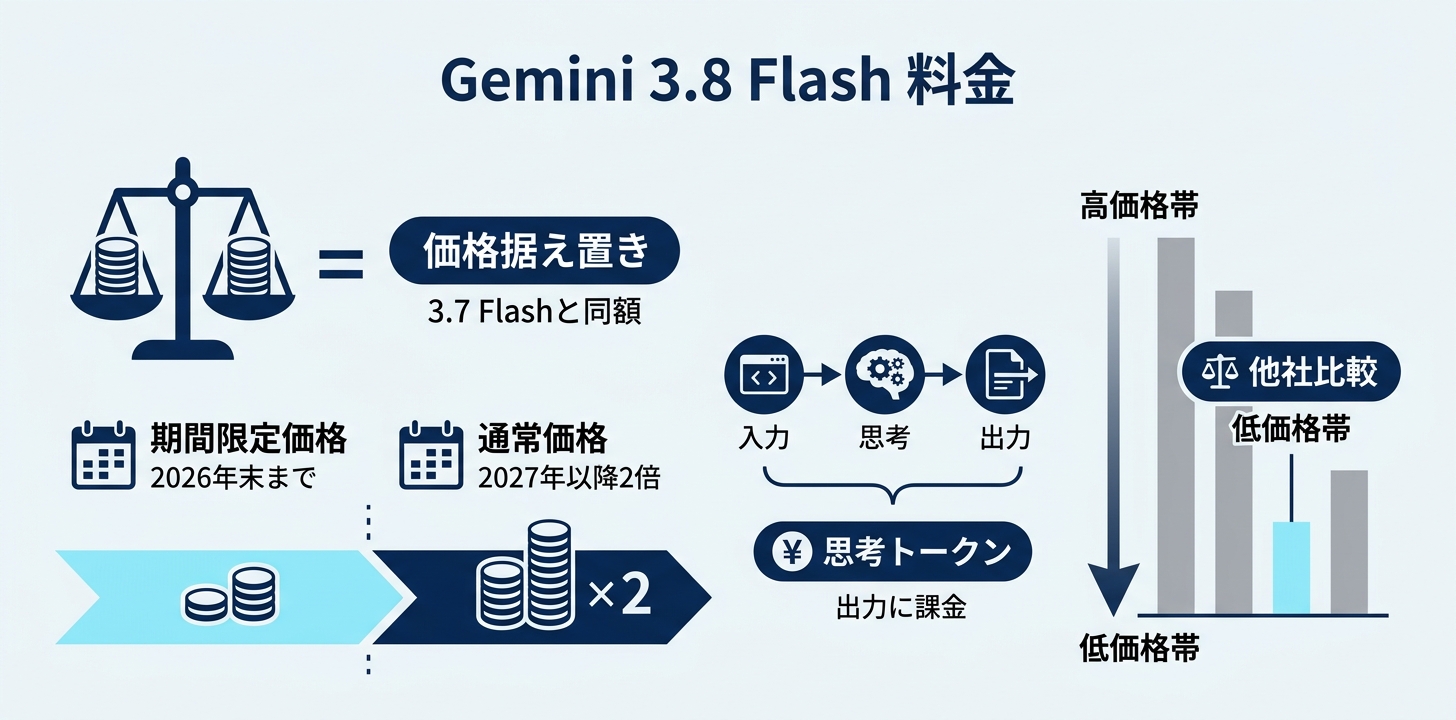
料金は、今回いちばん分かりやすい部分です。3.7 Flashとまったく同じ単価で提供されています。
| 項目 | 2026年12月31日まで | 2027年1月1日から |
|---|---|---|
| 入力(100万トークンあたり) | $0.75 | $1.50 |
| 出力(思考トークン込み・100万トークンあたり) | $3.75 | $7.50 |
| コンテキストキャッシュ(100万トークンあたり) | $0.075 | $0.15 |
(出典: Gemini API 料金ページ)
読み取れることは3つあります。
- 性能が上がったぶんの値上げはない — 3.7 Flashと同額です。同じ予算のまま、より良いスコアのモデルに切り替えられる状態になっています
- 年明けに単価が2倍になる — 2026年12月31日までは導入価格で、2027年1月1日から入力$1.50・出力$7.50に切り替わります。年内の検証結果をそのまま来年の予算に置き換えると足りなくなるので、試算するなら倍額のほうで組んでおくのが安全です
- 思考に使ったトークンも出力として課金される — 料金ページの出力単価は思考トークンを含む扱いです。画面に出てくる答えが短くても、裏で長く考えていればその分が乗ります。コストを左右するのは「どれだけ賢いか」だけでなく「どれだけ短く考えて答えに到達するか」です
3つめは実際の数字で見ると分かりやすくなります。前述の添削テストでは、表として返ってきた出力が2,395トークンだったのに対し、その裏で思考に8,008トークンを使っていました。課金はこの合計に対してかかります。
そしてもうひとつ、今回の評価資料には各社モデルのAPI価格が同じ表に並記されています。ベンチマークのスコアと同じ資料に載っている値なので、そのまま引用します。
| モデル | 入力(100万トークン) | 出力(100万トークン) |
|---|---|---|
| Gemini 3.8 Flash | $0.75(通常価格 $1.50) | $3.75(通常価格 $7.50) |
| Gemini 3.7 Flash | $0.75(通常価格 $1.50) | $3.75(通常価格 $7.50) |
| Claude Opus 5 | $5.00 | $25.00 |
| Claude Sonnet 5 | $2.00 | $10.00 |
| GPT-5.6 Sol | $4.00 | $20.00 |
| GPT-5.6 Terra | $2.00 | $12.00 |
(出典: Google DeepMind「Gemini 3.8 Flash Model Evaluation」(PDF)。他社の価格もGoogleが自社の比較表に載せた値です)
2026年12月31日までの導入価格で比べると、Claude Opus 5に対して入力・出力とも約7分の1の単価です。GPT-5.6 Solと比べても入力・出力ともに5倍以上の開きがあります。2027年1月1日以降はGemini側が倍額になるので、この開きは縮まります。
この価格差があるからこそ、前章のベンチマークが意味を持ってきます。Terminal-bench 2.1の89.4%対89.1%、DeepSWE v1.1の73.7%対74.0%(Claude Opus 5との比較)は、同じくらいのスコアを約7分の1の単価で出しているという読み方になるからです。
逆にTerminal-bench 4.0の19.1%対51.8%のような差が出る領域では、単価が7分の1でも安くは上がりません。やり直しが増えれば、そのぶんトークンを消費するためです。
安いモデルが得なのは、そのモデルが「一発で終わらせられる仕事」を任せたときだけ、ということです。
Google検索との接続(グラウンディング)は有料枠でのみ使えます。Gemini 3.x系のモデル全体で共有して月5,000件の検索リクエストまで追加料金なし、それを超えると1,000件あたり$14です。1回のリクエストから複数の検索クエリが走った場合は、クエリごとに課金されます(Gemini API 料金ページより)。検索を絡めた使い方を全社に広げるなら、この枠が最初の目安になります。
年内の単価が安いという事実は、そのまま「検証を今のうちに進めておく理由」になります。とはいえ、安い期間に急いで本番へ載せる話ではありません。年内に「どの業務なら任せられるか」を見極めておき、来年の単価で回しても割に合う使い方だけを残す。この順番で進めるのが現実的です。
法人向けAI研修の導入社数No.1*の弊社デジライズが提供する「法人リスキリング」の研修内容・支援の流れ・料金をまとめたサービス資料を無料でお送りしています。
※出典:株式会社東京商工リサーチ「法人向けリスキリングサービスに関する調査」(2026年5月/調査期間:2026年3月26日〜4月17日/調査方法:デスクリサーチおよびヒアリング/2026年3月末時点)
どこで使えるのか——開発者・法人・個人の3ルート
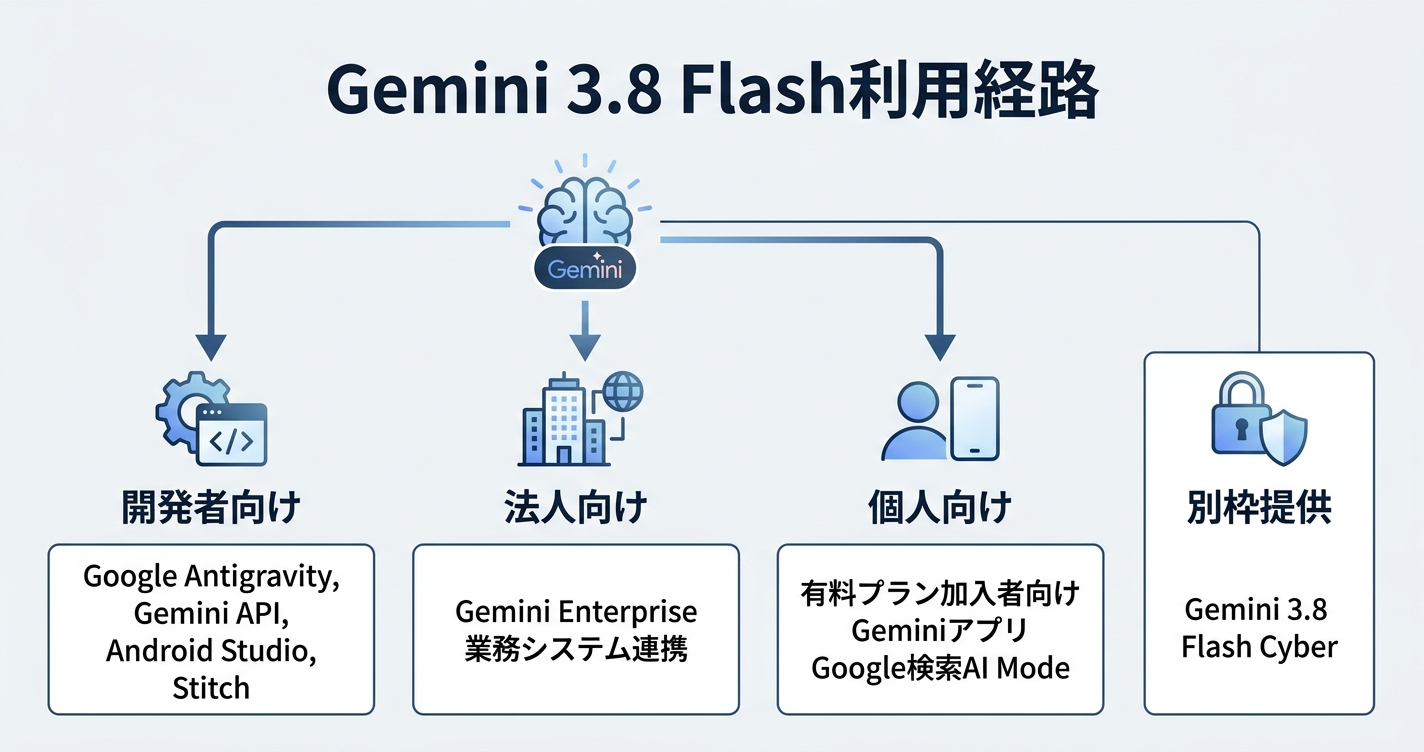
提供チャネルは大きく3つに分かれています(Google公式ブログより)。
- 開発者向け — Google Antigravity、Gemini API経由のGoogle AI Studio、Android Studio、UI生成のStitch。APIから直接呼ぶ場合はモデルIDに
gemini-3.8-flashを指定します - 法人向け — Gemini Enterprise。社内の業務システムやワークフローに組み込む場合はこのルートです
- 個人向け — Google AI ProおよびUltraの加入者向けに、Geminiアプリ、Google検索のAI Mode、GoogleスプレッドシートのGeminiで提供されます
ここで注意したいのが3つめです。Geminiアプリなどの一般ユーザー向けの製品では、有料プラン(Google AI Pro / Ultra)の加入者向けという案内になっていて、無料プランで使えるかどうかについては公式に言及がありません。なお、開発者向けのGemini APIには無料枠があります(Gemini API 料金ページより)。「新しいモデルが出たから、明日から社員全員が自分のアカウントで使える」とは限らない、ということです。社内で案内を出す前に、実際に自分のアカウントでモデルの選択肢に出てくるかを確認してください。
手元の仕事用アカウントには出ていません。 2026年9月18日にGeminiアプリで確認した時点では、モデルの選択肢は3.6 Flash/3.6 Thinking/3.1 Proの3つで、3.8 Flashはありませんでした。加入しているプランの違いによる可能性があるので、あなたの画面でも一度見てみてください。添削に使うなら、モデルIDを指定できるAPI経由が確実です。
日本向けには、Googleの日本公式ブログが2026年9月3日付で「本日より提供開始」と案内しています(Google Japan Blogより)。一方、日本語での入出力にどこまで対応しているかは、今回の公式発表には明示がありません。ここは各自の環境で確かめるしかない部分です。
なお、後述するGemini 3.8 Flash Cyberはこの3ルートのどれからも選べません。別枠の限定提供です。
Gemini 3.8 Flash Cyberとは?——Fairwind Program限定のセキュリティ特化モデル
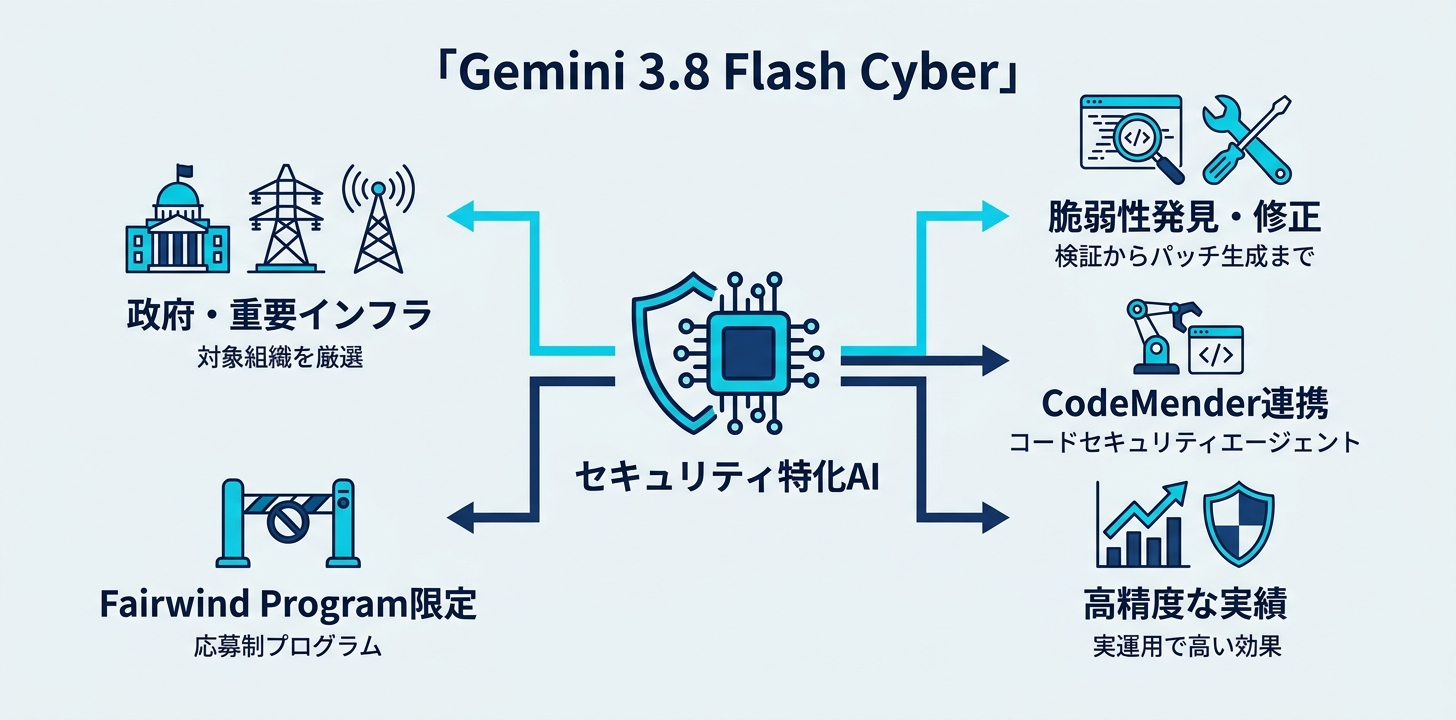
同時発表されたGemini 3.8 Flash Cyberは、サイバーセキュリティに特化したモデルです。やることは脆弱性を自分で見つけ、それが本物かを検証し、修正パッチまで書くこと。コードセキュリティエージェントのCodeMenderと組み合わせて提供されます。
まず前提として、このモデルは一般の企業や個人が選べるものではありません。提供はFairwind Programという応募制のプログラム経由に限られていて、対象は①政府機関・各国のサイバー当局 ②医療・通信・エネルギー・金融といった重要インフラの事業者 ③コア技術プラットフォームの提供者、の3種類です。参加する組織は、アクセスできる人を社内のサイバーセキュリティ/インシデント対応/ペネトレーションテストの担当者に限ること、多要素認証などの保護策を入れることに同意する必要があります(Google公式ブログ、Fairwind Programより)。
その上で、公開されている検証結果は「セキュリティ分野でAIがどこまで来ているか」を知る材料になります。
- Chromeでの実運用 — Chrome Securityチームでの利用で、はるかに規模の大きい商用モデルと比べて2.6倍の正しいパッチを生成しました
- CWE-Bench — 外部のパッチ生成ベンチマークでpass@1が47.2%。比較対象として挙げられているフロンティアモデル(モデル名は非公表)は47.8%で、Googleはスコアがほぼ並びながらコストは大幅に低いと説明しています
- 20言語対応の内部ベンチマーク — 成功率70%超
- Wizでの実運用 — 他のフロンティアモデルと比べて検出のリコールが7.5〜9.7%高く、コストは2.3〜5.2倍安いという結果
- Google Cloud Vulnerability Researchチーム — 通常なら数か月かかる重大な基盤的脆弱性の発見を、2時間未満で達成
(出典: Google公式ブログ)
Fairwind Programには世界で650を超えるパートナーが参加しています(Fairwind Programより。これはプログラム全体の参加組織数で、Gemini 3.8 Flash Cyber単体の数字ではありません)。
一般の企業が今日から使える話ではないと書きましたが、それでもこの発表を追う価値はあると私は考えています。「数か月かかっていた脆弱性の発見が2時間で終わる」という水準が、限定的とはいえ実際の運用の中で出ているからです。同じ能力は攻撃側にも効きます。自社のセキュリティ体制を考えるとき、前提として頭に入れておきたい変化です。
ここまで読んで「自社の業務にどう取り入れるか、社内でどう広げるかを具体的に考えたくなった」という方へ。法人向けAI研修の導入社数No.1*の弊社デジライズが、生成AIの基礎知識から社内導入の6ステップ・定着のポイントまでを1冊にまとめた「はじめての生成AI社内導入ガイド」を無料で配布中です。
※出典:株式会社東京商工リサーチ「法人向けリスキリングサービスに関する調査」(2026年5月/調査期間:2026年3月26日〜4月17日/調査方法:デスクリサーチおよびヒアリング/2026年3月末時点)
まとめ
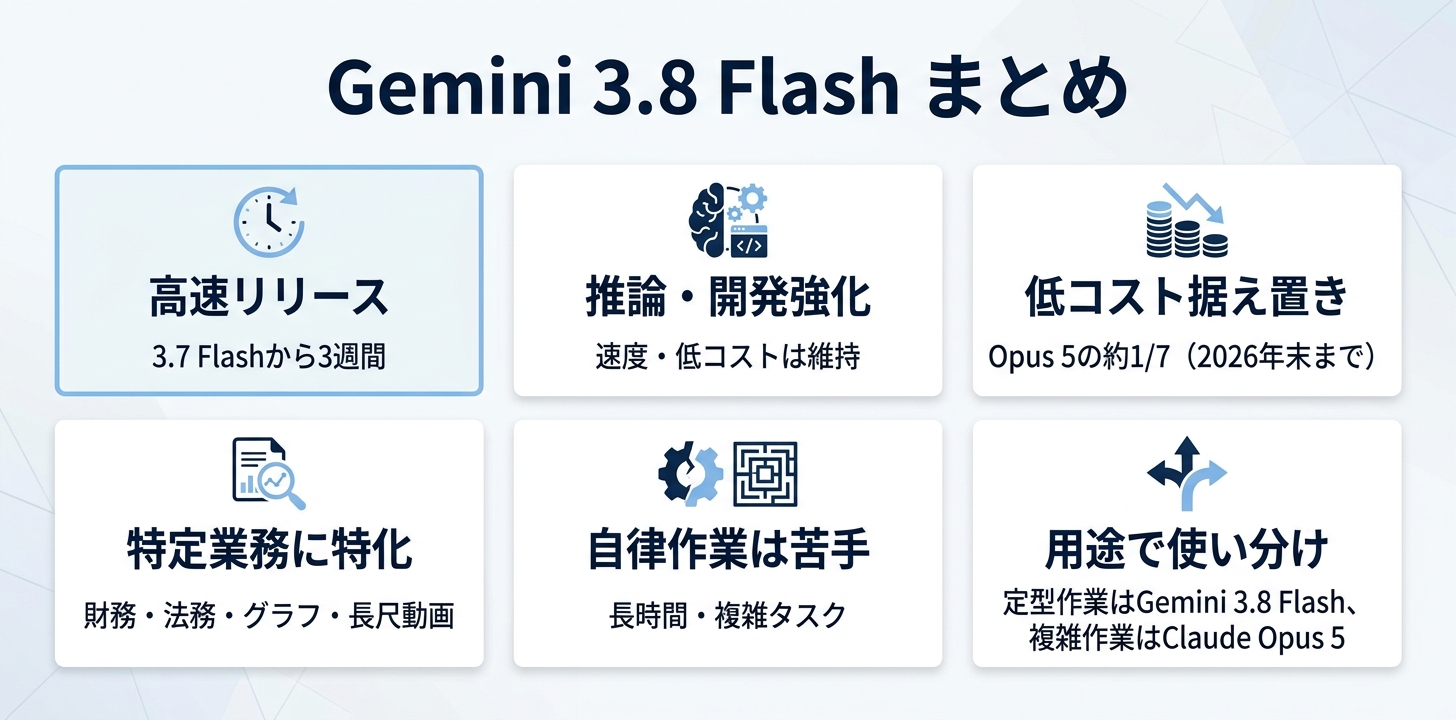
Gemini 3.8 Flashについて、ここまでの内容を整理します。
- 有意義な使い方は「添削役」 — 上位モデルに書かせた文章を整える側に回すと噛み合います。14,463字の下書きで試したところ、27.8秒で23件の指摘が返り、費用は約4.5セント。採用したのは7件でした
- 3.7 Flashからわずか3週間、6週間でFlash系3本目 — Googleの説明は「3.7と同じ速度・同じ低コストのまま、推論とコーディングを強化した」というもの。速くなったとは言っていません
- 3.7 Flashは併存している — 3.8 Flashは3.7 Flashをベースに作られたモデルで、料金ページには3.7 Flashも残っています。今動いているものを慌てて切り替える必要はありません
- 料金は完全据え置き — 入力$0.75・出力$3.75(2026年12月31日まで)。Googleの比較表ではClaude Opus 5の約7分の1の単価です。2027年1月1日から倍額になるので、試算は倍額側で組む
- 得意と不得意がはっきりしている — 財務・法務・グラフ・長尺動画では比較6モデル中の最高値。一方でTerminal-bench 4.0(汎用的なエージェント能力)やOSWorld-2.0(PC画面の操作)ではClaude Opus 5に大きく離されています
- ベンチマークは条件とセットで読む — 他社モデルの多くは自己公表値、HLE-VerifiedではClaude系の一部設問がブロックされ、LVBenchはフレーム数が揃っていません。0.3ポイント差で順位を語らないこと
- Cyberは限定提供 — Gemini 3.8 Flash CyberはFairwind Program経由でのみ提供され、一般の企業は選べません
使い分けの結論はシンプルです。決まった作業を大量に安く回すならGemini 3.8 Flash、汎用的なエージェント作業やPC操作まで任せるならClaude Opus 5。文章まわりで言えば、書かせるのは上位モデル、整えさせるのはGemini 3.8 Flashという分け方がそのまま当てはまります。まずは自社の業務をこの2つに切り分けるところから始めてみてください。年内は導入価格で試せるので、検証を進めるには良いタイミングです。
前世代のGemini 3.7 Flashの仕様や、思考トークンの使われ方の実測比較を知りたい方は、以下の記事をご覧ください。
 2026.08.18
Gemini 3.7 Flashとは?料金と、3.6 Flashより思考トークンが半分以下になった実測比較
比較の相手になったClaude Opus 5そのものについては、こちらで詳しく解説しています。
 2026.07.29
2026.08.10
Claude Opus 5とは?Fable 5に迫る性能を半額で提供する新主力モデルを解説
6週間で3本という更新の流れを最初から追いたい方は、Gemini 3.6 Flashの記事もあわせてどうぞ。
 2026.07.29
2026.08.10
Gemini 3.6 Flash・3.5 Flash-Lite・3.5 Flash Cyberとは?Googleが新モデル3種を同時発表
この記事を書いた人
株式会社デジライズ代表取締役CEO。企業向けAI研修・AI導入コンサル・システム開発を一気通貫で提供し、累計600社超・5万人以上を支援。法人向けAIリスキリングサービス導入社数No.1(東京商工リサーチ・2026年3月末)。GMO AI & Web3顧問、Google Gemini AIアドバイザー。Xフォロワー20万人超。
あわせて読みたい
 Google Workspace Studioとは?使い方・料金・活用事例30選を徹底解説 2025.12.04 ・ 🔥 19,942
 Gemini Sparkとは?常時稼働AIエージェントの機能・料金・日本提供を解説 2026.05.21 ・ 🔥 11,170
 【徹底解説】Gemini 3 Flashとは?料金・使い方・Proとの違いを動画つきで最速解説 2025.12.18 ・ 🔥 10,405
 【2026年最新版】GoogleのAIツール完全ガイド|無料で使えるサービスと有料版の違いを完全比較 2025.11.10 ・ 🔥 8,359
 【プロンプト付き】Nano Banana 2ビジネス活用事例9選|料金・制限・Proとの違いも解説 2025.11.26 ・ 🔥 7,132
 NotebookLM 音声解説(Audio Overview)完全ガイド【2026年版】プロンプト10選付き 2025.11.05 ・ 🔥 5,442